ai图楼
DeiR发布于 2026-09-25 15:31
Re: ai图楼
wow是粥 必须资瓷——
第一次发现二刺螈专享的NovelAI,学习了。生成效果也还不错啊!
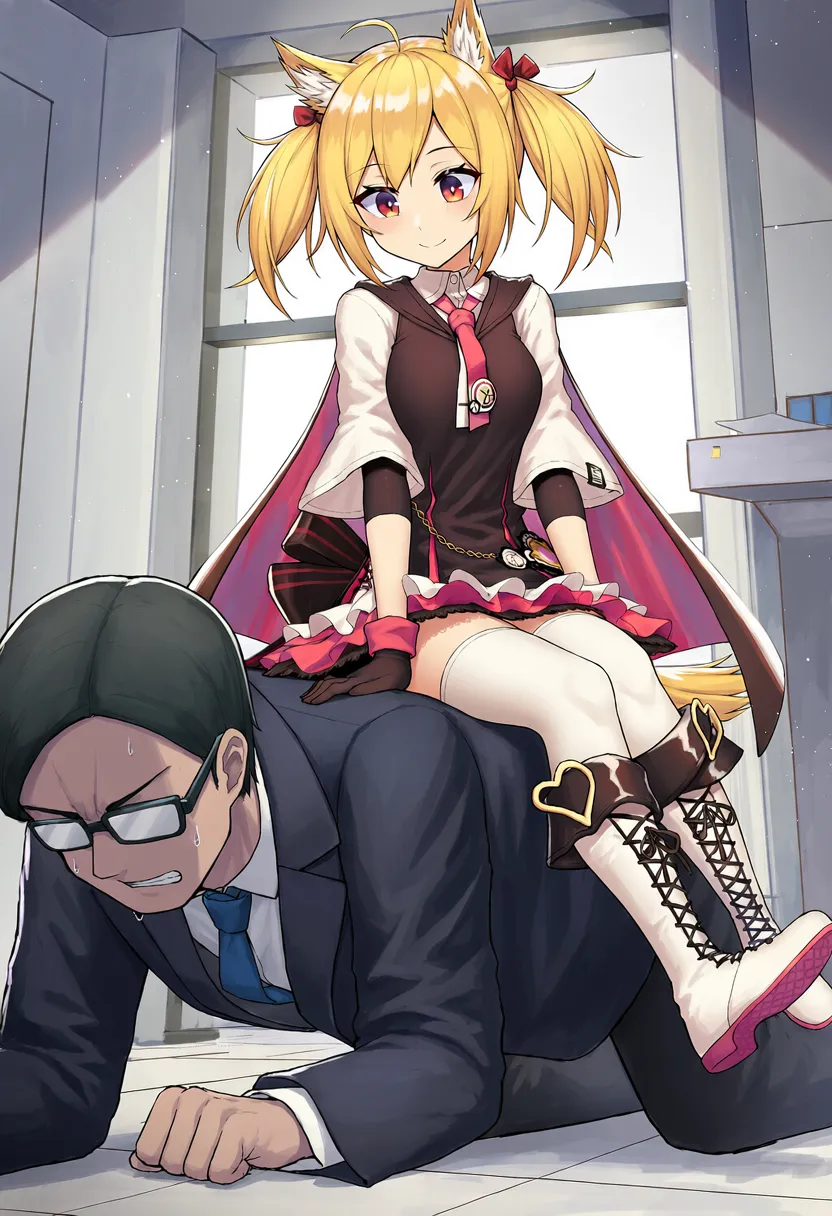
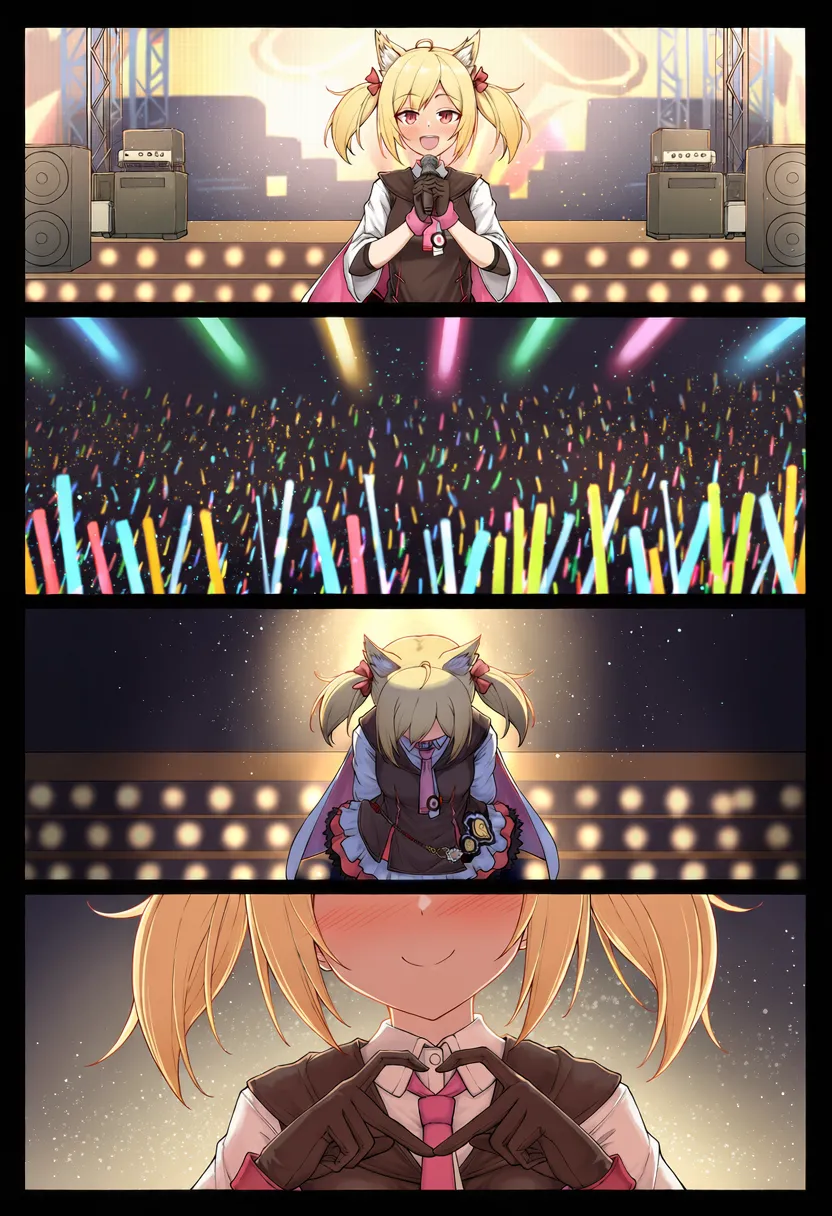
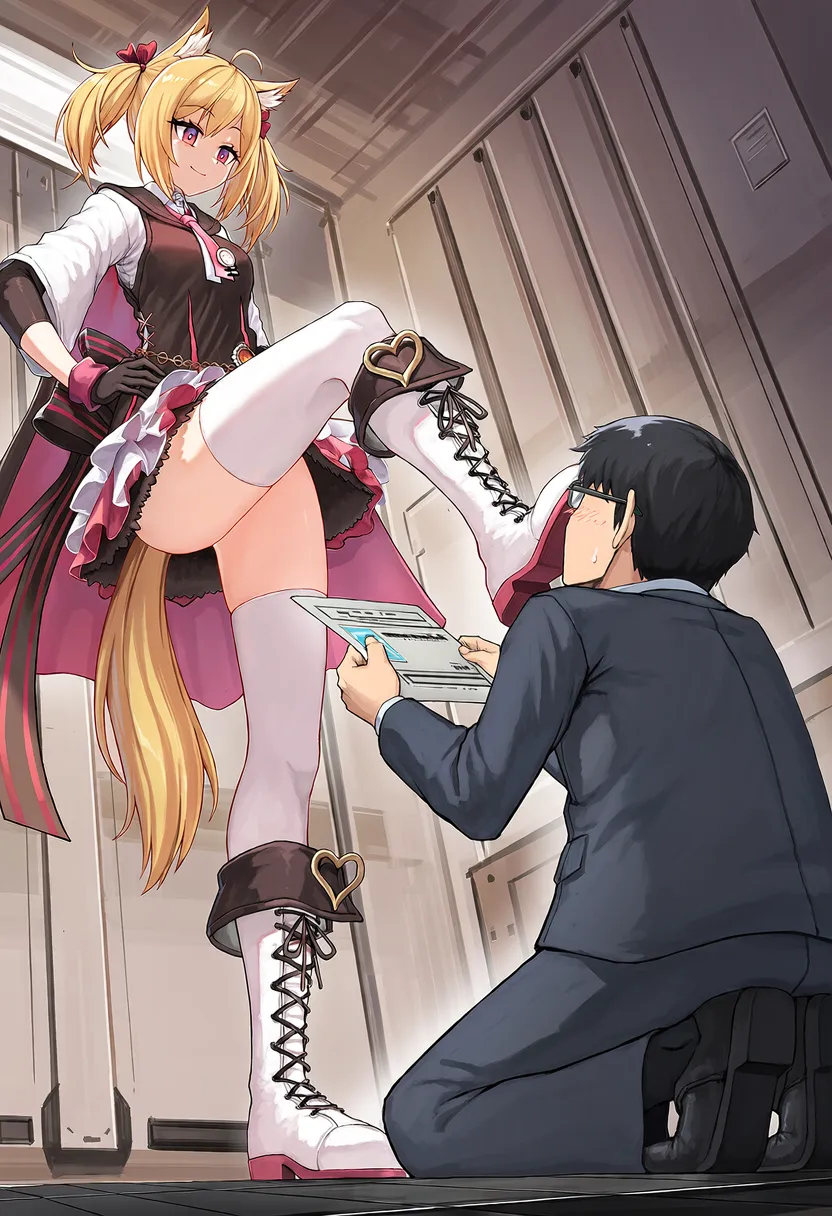
话说仔细一看发现AI做的漫画有几个小问题:
表情比较模板,而且大部分时候身体姿势不参与表达情绪。
有少数几张图会有线来表现动作的力度,但绝大部分是没有的。
透视和视角有点单一,大多是一个角度切几个画面。
有几张人体结构不太一致,尤其是有一张抬腿的图。
表现受力表现得一般,比如说背上坐了个人的时候人体受力姿势。
分镜不太抓得到一个有冲击力的动作,大部分是连续地状态叙事(其实和第三点有点类似),好像没能有主有次地“放大画面”,排布镜头。
不知道这些点能不能通过优化提示词来改变,希望不要被这些挑刺打击到啊——(发自内心地)感谢分享!
第一次发现二刺螈专享的NovelAI,学习了。生成效果也还不错啊!
话说仔细一看发现AI做的漫画有几个小问题:
表情比较模板,而且大部分时候身体姿势不参与表达情绪。
有少数几张图会有线来表现动作的力度,但绝大部分是没有的。
透视和视角有点单一,大多是一个角度切几个画面。
有几张人体结构不太一致,尤其是有一张抬腿的图。
表现受力表现得一般,比如说背上坐了个人的时候人体受力姿势。
分镜不太抓得到一个有冲击力的动作,大部分是连续地状态叙事(其实和第三点有点类似),好像没能有主有次地“放大画面”,排布镜头。
不知道这些点能不能通过优化提示词来改变,

qgtya发布于 2026-09-25 16:25
Re: ai图楼

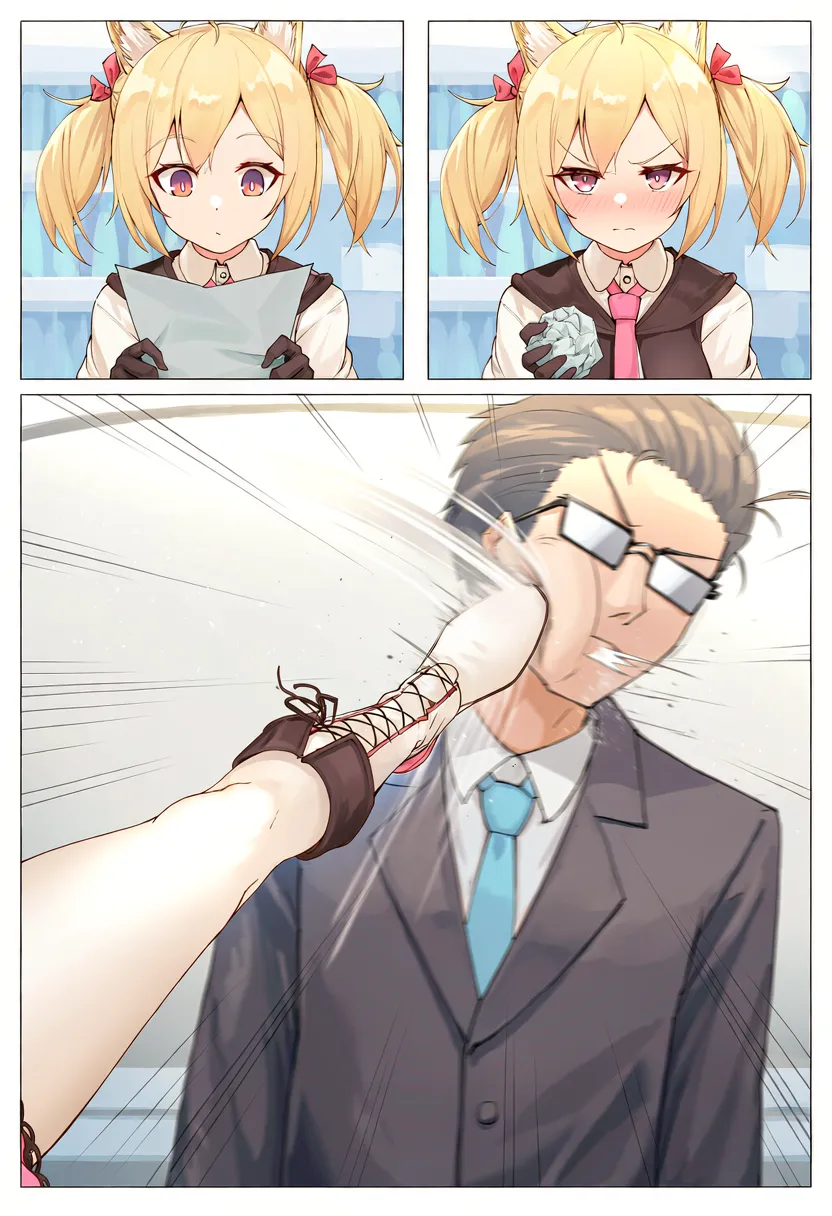
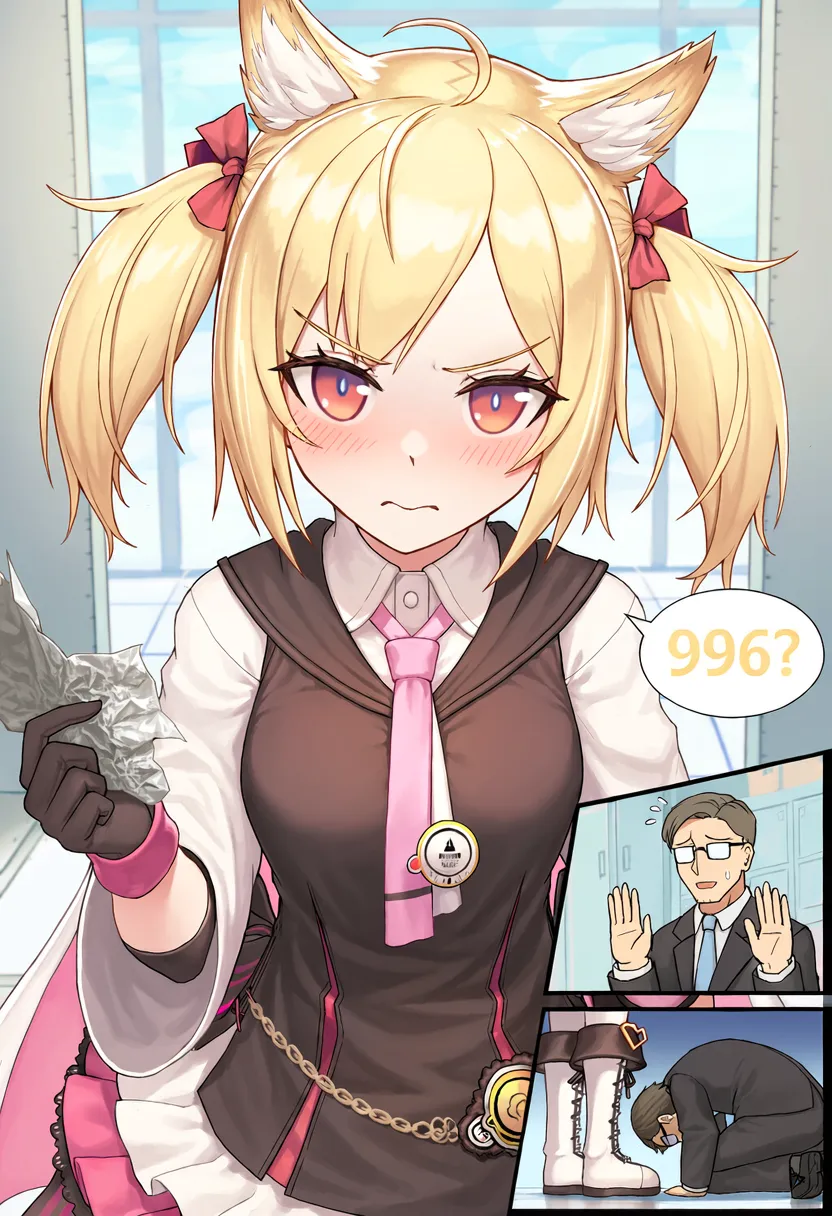
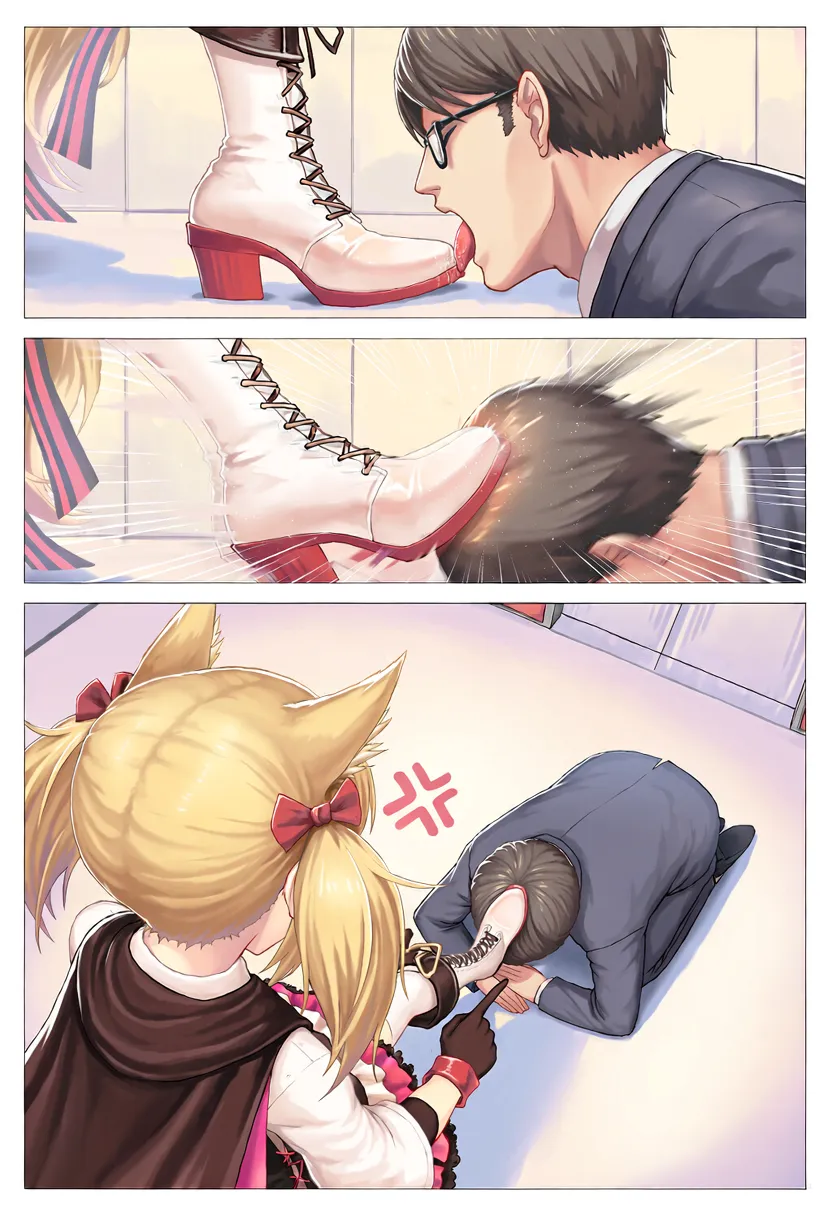
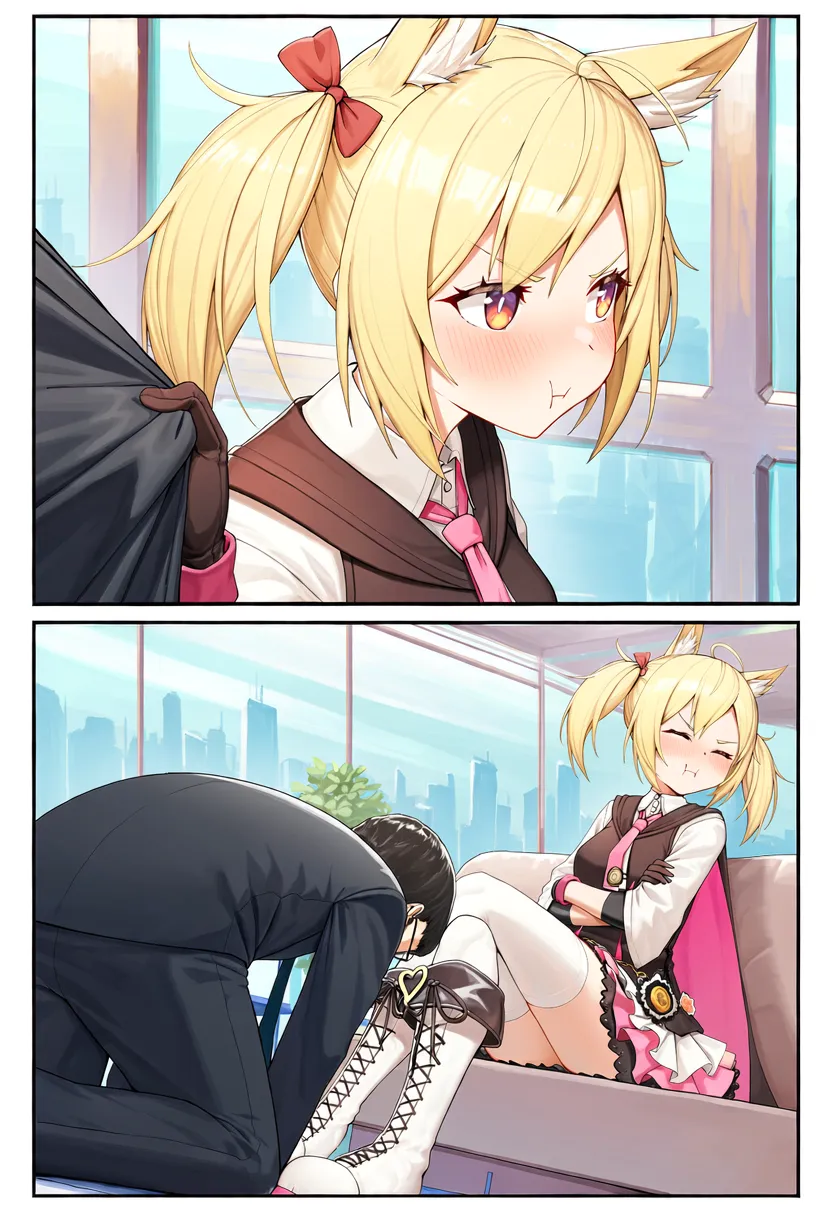
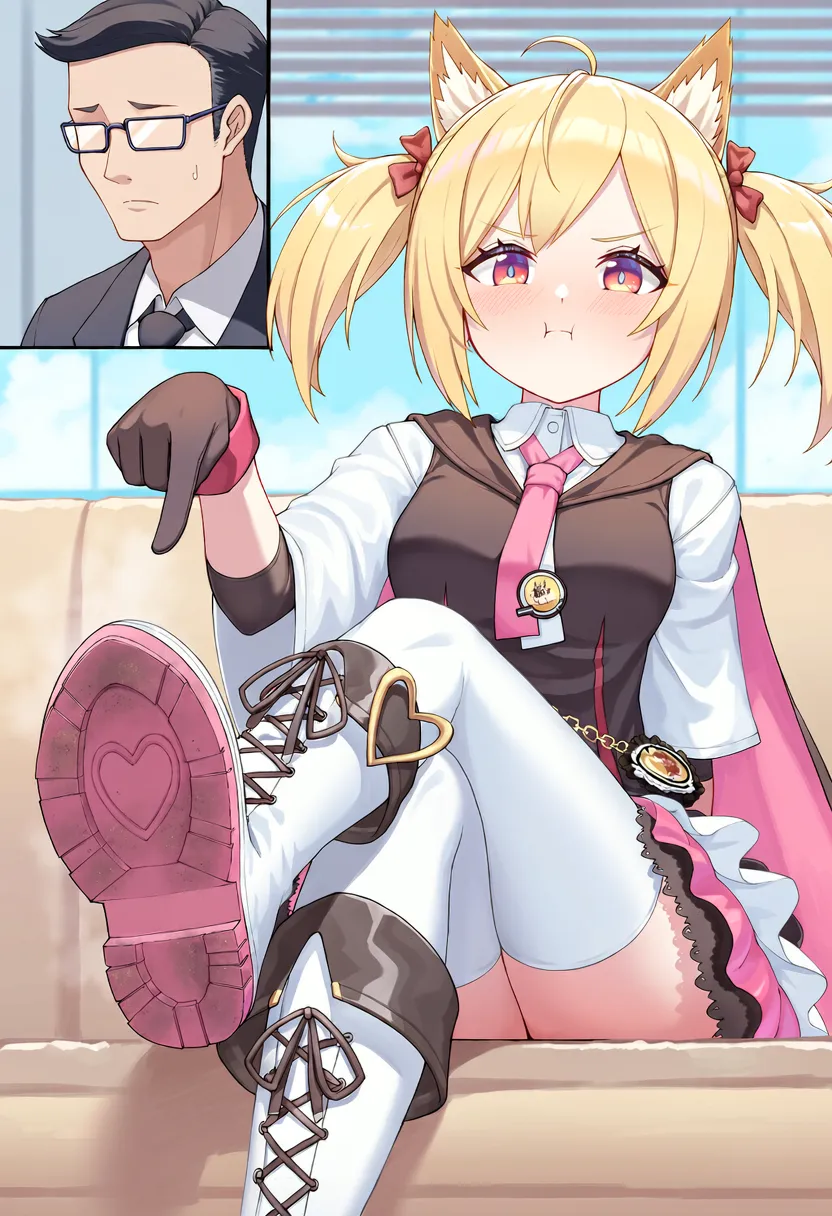
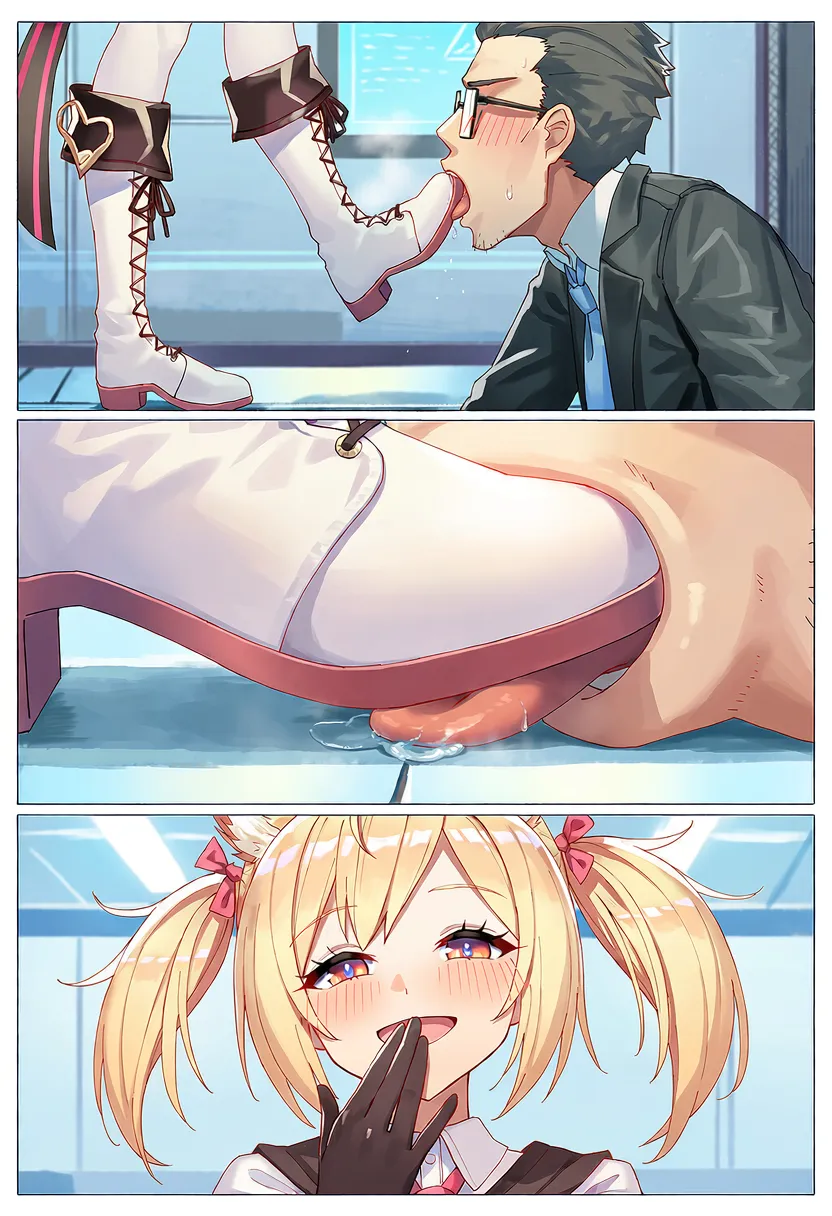
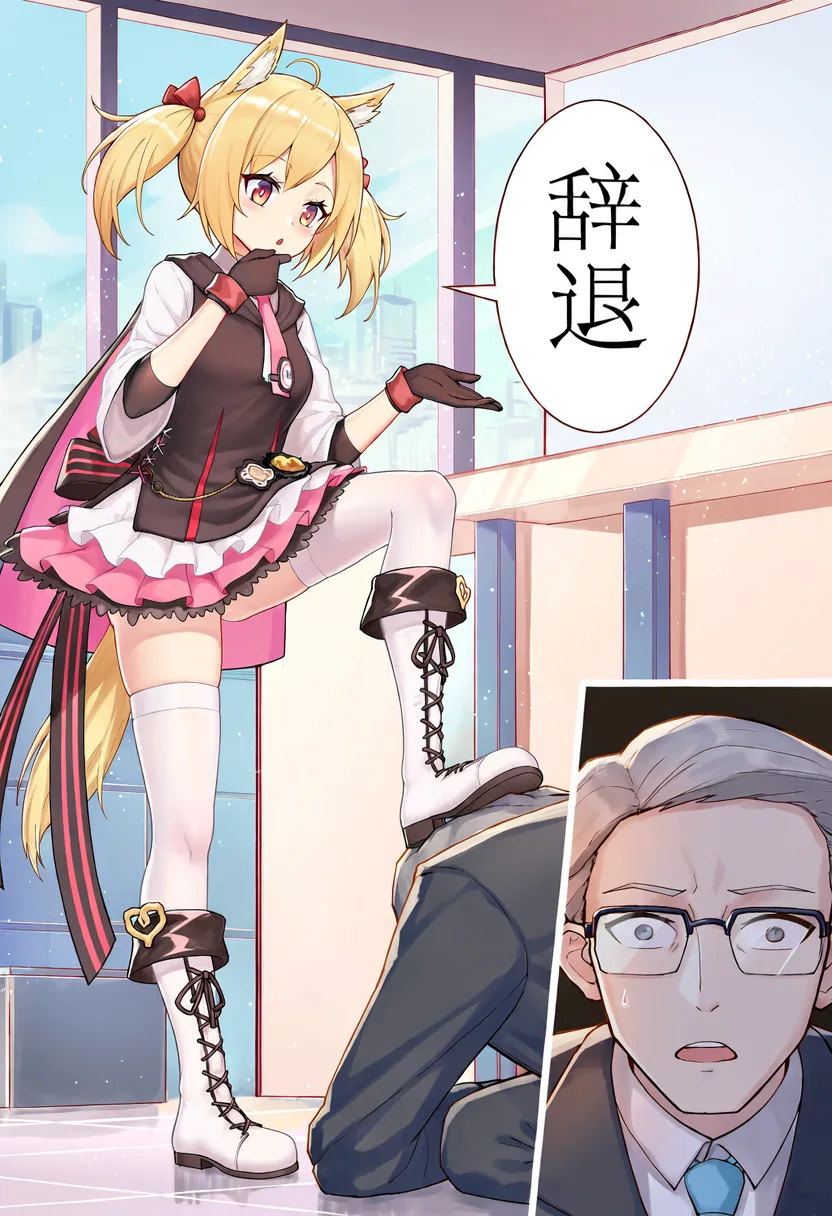


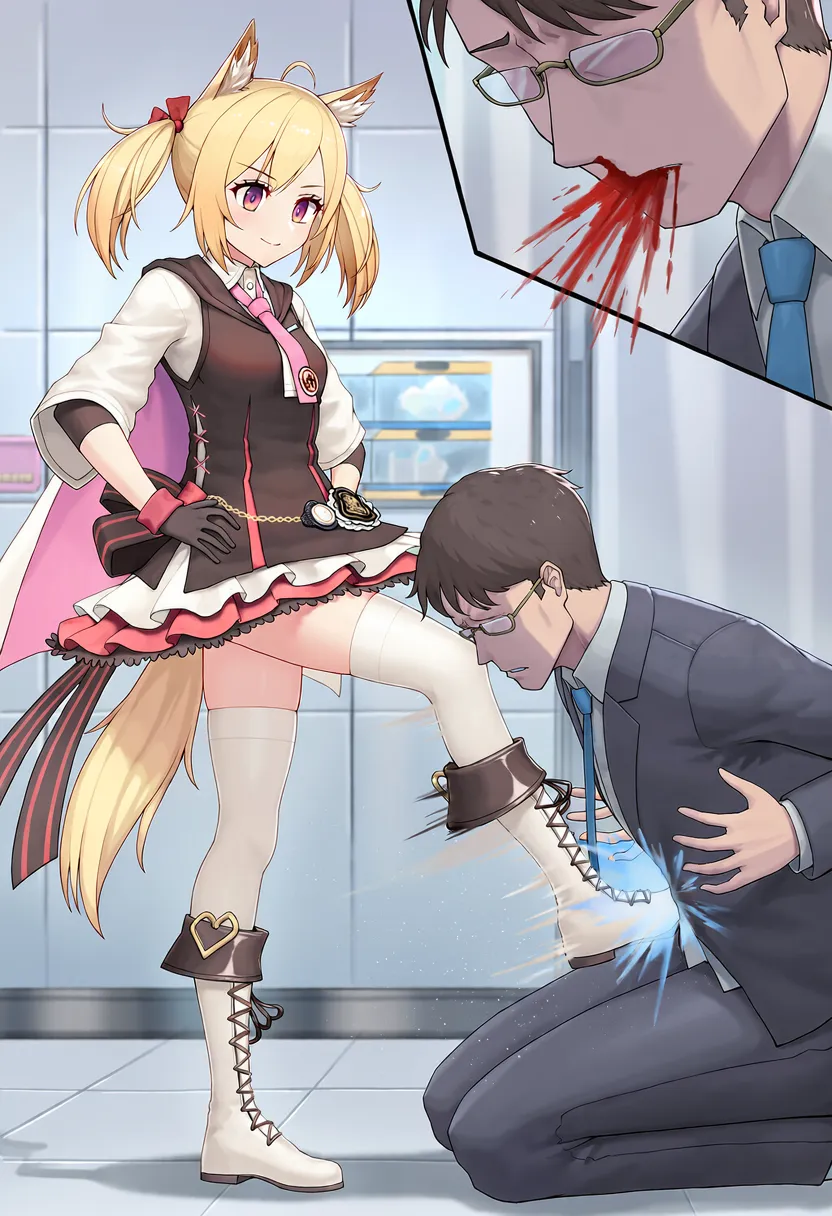

想被魔法少女踩踏发布于 2026-09-25 23:44
Re: ai图楼
DeiR:↑wow是粥 必须资瓷——感谢长评~首先我要说明,虽然novelai支持自然语言输入(也就是中文),但ai的理解还是差点,所以我是先把想法说给ds,然后让大肥鱼翻译成英语,再复制粘贴到ai上的,ds写的提示词我基本不检查,出了差错我也很难注意。。下面我来回答一下你的提出的问题
第一次发现二刺螈专享的NovelAI,学习了。生成效果也还不错啊!
话说仔细一看发现AI做的漫画有几个小问题:
表情比较模板,而且大部分时候身体姿势不参与表达情绪。
有少数几张图会有线来表现动作的力度,但绝大部分是没有的。
透视和视角有点单一,大多是一个角度切几个画面。
有几张人体结构不太一致,尤其是有一张抬腿的图。
表现受力表现得一般,比如说背上坐了个人的时候人体受力姿势。
分镜不太抓得到一个有冲击力的动作,大部分是连续地状态叙事(其实和第三点有点类似),好像没能有主有次地“放大画面”,排布镜头。
不知道这些点能不能通过优化提示词来改变,希望不要被这些挑刺打击到啊——(发自内心地)感谢分享!
1.表情和姿势这个,我写提示词时确实很少考虑,以后会多想想的
2.动作力度这个也和我的提示词有关,我想到了就要求它加上,默认情况下是没有的
3.透视和视角这个。。我没有这方面的基础,只能凭感觉来了
4.人体是ai老大难问题了,现阶段就凑合看吧。。
5.受力这个。。也是和我没有美术功底有关吧。。
6.我确实是先考虑叙事的,对于分镜的编排没有过多的研究,还有一点就是novelai不太支持根据前面的图片来生成新的图片,所以读起来有割裂感,没有层次感也很正常。。然后呢生成的单张漫画越复杂越容易出现鬼图,有时候我不得不分几p来讲述一张漫画的内容,这个是模型的缺陷,只能想想看怎样绕开它了(嗯,要学分镜)
最后多问一句,有没有漫画入门的视频推荐,我去学习一下
想被魔法少女踩踏发布于 2026-09-25 23:49
Re: ai图楼
DeiR发布于 ,编辑于 2026-09-26 00:42
Re: ai图楼
想被魔法少女踩踏:↑今天回复完以后我去B站看了看NAI V5的测评,我发现是可以改掉我提到的问题的。【NAI5王朝?NovelAI V5黑白漫画能力测试结果展示】https://www.bilibili.com/video/BV1XCtP6qEwM?vd_source=cdf5746d24153c5d06bcea19eecc195fDeiR:↑wow是粥 必须资瓷——感谢长评~首先我要说明,虽然novelai支持自然语言输入(也就是中文),但ai的理解还是差点,所以我是先把想法说给ds,然后让大肥鱼翻译成英语,再复制粘贴到ai上的,ds写的提示词我基本不检查,出了差错我也很难注意。。下面我来回答一下你的提出的问题
第一次发现二刺螈专享的NovelAI,学习了。生成效果也还不错啊!
话说仔细一看发现AI做的漫画有几个小问题:
表情比较模板,而且大部分时候身体姿势不参与表达情绪。
有少数几张图会有线来表现动作的力度,但绝大部分是没有的。
透视和视角有点单一,大多是一个角度切几个画面。
有几张人体结构不太一致,尤其是有一张抬腿的图。
表现受力表现得一般,比如说背上坐了个人的时候人体受力姿势。
分镜不太抓得到一个有冲击力的动作,大部分是连续地状态叙事(其实和第三点有点类似),好像没能有主有次地“放大画面”,排布镜头。
不知道这些点能不能通过优化提示词来改变,希望不要被这些挑刺打击到啊——(发自内心地)感谢分享!
1.表情和姿势这个,我写提示词时确实很少考虑,以后会多想想的
2.动作力度这个也和我的提示词有关,我想到了就要求它加上,默认情况下是没有的
3.透视和视角这个。。我没有这方面的基础,只能凭感觉来了
4.人体是ai老大难问题了,现阶段就凑合看吧。。
5.受力这个。。也是和我没有美术功底有关吧。。
6.我确实是先考虑叙事的,对于分镜的编排没有过多的研究,还有一点就是novelai不太支持根据前面的图片来生成新的图片,所以读起来有割裂感,没有层次感也很正常。。然后呢生成的单张漫画越复杂越容易出现鬼图,有时候我不得不分几p来讲述一张漫画的内容,这个是模型的缺陷,只能想想看怎样绕开它了(嗯,要学分镜)
最后多问一句,有没有漫画入门的视频推荐,我去学习一下
看你的叙述我发现可能是提示词的问题,好像是把想法翻译完直接放到prompt栏了。推荐用随便一个聪明点的模型让它生成
然后对于“想法”这一部分,可以自己在构思的时候就思考一下:这部分想突出什么动作/冲突,人物有什么情绪的时候可能有什么动作、画面视觉重心在哪里、想用谁的视角表现,总体想呈现什么风格……(
B站我看有好多免费的V5教程,可以挑个喜欢的看看。
想被魔法少女踩踏发布于 2026-09-27 00:39
Re: ai图楼
DeiR:↑emmm,我觉得你可能没用过,不知道上手的难度。。反正现在ai还做不到如臂使指,有些时候是要用折衷的方案来实现脑海中的画面。。就这样还要经过反复的抽卡。。只能说,我尽力吧想被魔法少女踩踏:↑今天回复完以后我去B站看了看NAI V5的测评,我发现是可以改掉我提到的问题的。【NAI5王朝?NovelAI V5黑白漫画能力测试结果展示】https://www.bilibili.com/video/BV1XCtP6qEwM?vd_source=cdf5746d24153c5d06bcea19eecc195fDeiR:↑wow是粥 必须资瓷——感谢长评~首先我要说明,虽然novelai支持自然语言输入(也就是中文),但ai的理解还是差点,所以我是先把想法说给ds,然后让大肥鱼翻译成英语,再复制粘贴到ai上的,ds写的提示词我基本不检查,出了差错我也很难注意。。下面我来回答一下你的提出的问题
第一次发现二刺螈专享的NovelAI,学习了。生成效果也还不错啊!
话说仔细一看发现AI做的漫画有几个小问题:
表情比较模板,而且大部分时候身体姿势不参与表达情绪。
有少数几张图会有线来表现动作的力度,但绝大部分是没有的。
透视和视角有点单一,大多是一个角度切几个画面。
有几张人体结构不太一致,尤其是有一张抬腿的图。
表现受力表现得一般,比如说背上坐了个人的时候人体受力姿势。
分镜不太抓得到一个有冲击力的动作,大部分是连续地状态叙事(其实和第三点有点类似),好像没能有主有次地“放大画面”,排布镜头。
不知道这些点能不能通过优化提示词来改变,希望不要被这些挑刺打击到啊——(发自内心地)感谢分享!
1.表情和姿势这个,我写提示词时确实很少考虑,以后会多想想的
2.动作力度这个也和我的提示词有关,我想到了就要求它加上,默认情况下是没有的
3.透视和视角这个。。我没有这方面的基础,只能凭感觉来了
4.人体是ai老大难问题了,现阶段就凑合看吧。。
5.受力这个。。也是和我没有美术功底有关吧。。
6.我确实是先考虑叙事的,对于分镜的编排没有过多的研究,还有一点就是novelai不太支持根据前面的图片来生成新的图片,所以读起来有割裂感,没有层次感也很正常。。然后呢生成的单张漫画越复杂越容易出现鬼图,有时候我不得不分几p来讲述一张漫画的内容,这个是模型的缺陷,只能想想看怎样绕开它了(嗯,要学分镜)
最后多问一句,有没有漫画入门的视频推荐,我去学习一下
看你的叙述我发现可能是提示词的问题,好像是把想法翻译完直接放到prompt栏了。推荐用随便一个聪明点的模型让它生成NAI好理解的分镜,列出每格分别的内容,不懂分镜设计也没关系(我也不懂)就靠AI润色了。
然后对于“想法”这一部分,可以自己在构思的时候就思考一下:这部分想突出什么动作/冲突,人物有什么情绪的时候可能有什么动作、画面视觉重心在哪里、想用谁的视角表现,总体想呈现什么风格……(
B站我看有好多免费的V5教程,可以挑个喜欢的看看。
qgtya发布于 2026-09-27 02:08
Re: ai图楼
刷到楼主pixiv了,奇妙的缘分